Hay una objeción que aparece siempre que alguien propone medir visibilidad en IA. Y es buena.
Si le haces la misma pregunta a ChatGPT dos veces, te da dos respuestas distintas. Entonces, ¿qué valor tiene un informe que dice que apareciste el 23% de las veces? ¿No es simplemente la foto de un momento que ya no existe?
La objeción es correcta en los hechos y equivocada en la conclusión. Sí, la respuesta cambia. No, eso no convierte la medición en imposible. Lo que hace es obligar a medir de otra manera.
Cuánto cambia en realidad
Durante mucho tiempo esto se discutió por intuición. Ahora hay números.
Rand Fishkin, de SparkToro, y Patrick O'Donnell, de Gumshoe, publicaron en enero de 2026 uno de los estudios de referencia sobre el tema. Reclutaron a 600 voluntarios. Lanzaron 12 consultas de recomendación de marca sobre ChatGPT, Claude y la IA de Google. En total, 2.961 ejecuciones, entre 60 y 100 repeticiones por consulta y motor.
Dos resultados, y conviene leerlos despacio.
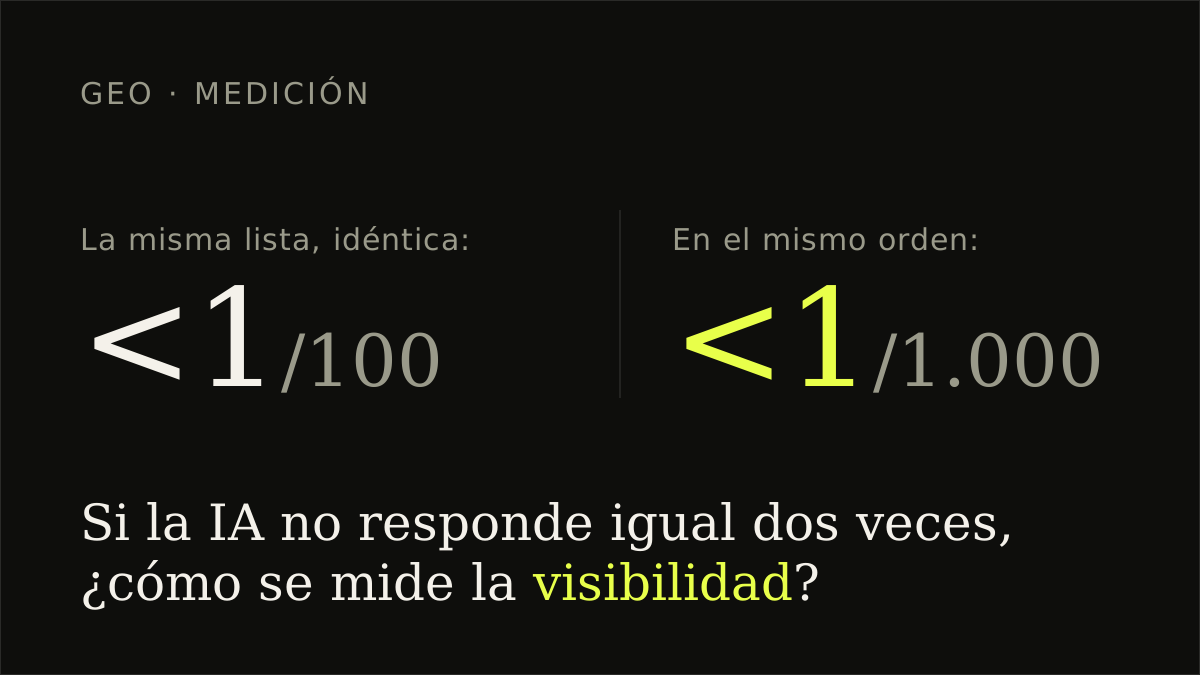
Ante consultas repetidas de recomendación, ChatGPT y la IA de Google devolvían la misma lista de marcas menos de una vez de cada cien.
La misma lista en el mismo orden aparecía menos de una vez de cada mil.
Conviene acotar el alcance, porque se cita más de lo que mide. El estudio analizó consultas que piden recomendaciones de marcas y productos. No demuestra que toda clase de respuesta de IA cambie con la misma frecuencia.
Fishkin lo resume sin rodeos: estos sistemas están construidos para generar una respuesta única cada vez, no para devolver un ranking estable. Su conclusión es que cualquier herramienta que te dé una posición de ranking en IA como si fuera una posición de Google no es fiable.
Hay una corroboración independiente que apunta en la misma dirección. Search Engine Land publicó en julio de 2026 que las citas de ChatGPT cambian cuando el sistema modifica internamente sus mecanismos de recuperación. Dos personas que hagan exactamente la misma pregunta en momentos distintos pueden recibir respuestas parecidas en contenido y sostenidas por fuentes completamente diferentes.
Pero hay una segunda mitad que casi nadie está contando
Si el artículo terminase aquí, la conclusión sería que medir no sirve. Y el mismo estudio dice lo contrario.
Mientras la lista completa casi nunca se repetía, algunas marcas aparecían con una regularidad notable. City of Hope salió en el 97% de las respuestas sobre atención oncológica. SmartSites en el 89% de las de consultoría de marketing. Las marcas líderes de auriculares, entre el 55% y el 77%, pese a que las preguntas estaban escritas por personas distintas y con palabras muy distintas.
Ahí está la distinción que lo ordena todo:
La lista concreta es ruido. La presencia repetida es señal.
No son lo mismo y no se miden igual. Preguntar "¿qué contesta ChatGPT a esta consulta?" es preguntar por el ruido, y la respuesta caduca en minutos. Preguntar "¿en qué porcentaje de cien ejecuciones aparece mi marca?" es preguntar por la señal, y esa respuesta aguanta.
Es el mismo principio que usa cualquiera que trabaje con datos ruidosos. Una sola medición no permite distinguir una tendencia de una variación puntual. Un conjunto suficiente de mediciones de lo mismo, sí.
Y hay un segundo estudio que lo confirma desde otro ángulo
En septiembre de 2026, OtterlyAI publicó un análisis mucho mayor: 252.407 respuestas sobre 520 consultas, siete motores y hasta 91 días de seguimiento diario en Estados Unidos.
Midió algo distinto a SparkToro. En vez de repetir una consulta muchas veces seguidas, siguió las mismas consultas día tras día. Y encontró una separación clara.
Las menciones de marca son bastante más estables que las fuentes citadas. En una ventana de 30 días, entre el 12% y el 19% de las marcas aparecieron un solo día. Entre las fuentes, esa cifra se movió entre el 26% y el 67%. En Google AI Mode, cerca de dos tercios de las fuentes fueron de un solo día, frente al 17% de las marcas.
Dicho de otro modo: qué páginas cita un motor cambia mucho más que a qué empresas nombra.
Hay una excepción que conviene registrar. Perplexity quedó fuera de esa comparación porque el 82% de sus respuestas no contenía ninguna mención de marca. Si alguien te presenta un Share of Voice de Perplexity sin explicar ese detalle, merece una pregunta.
Nuestra propia herramienta tiene el problema
Conviene demostrar esto con algo propio antes de pedirle a nadie que se lo crea.
En agosto de 2026, durante las pruebas de nuestro GEO Checker, analizamos el mismo sitio dos veces seguidas. La primera ejecución dio una puntuación de 57. La segunda, 49.
Ocho puntos de diferencia sobre el mismo dominio, en el mismo minuto, sin que nada hubiera cambiado en la web.
Conviene ser preciso con lo que ese dato demuestra, porque es fácil estirarlo de más. El Checker no consulta ChatGPT, Perplexity ni Gemini. Hace búsquedas web y un modelo evalúa lo que encuentra. Así que esa diferencia no mide volatilidad en las respuestas de los motores.
Lo que demuestra es esto: nuestro propio proceso de evaluación puede devolver resultados distintos sobre un mismo dominio en ejecuciones consecutivas.
Y hay que ser igual de preciso con lo que no sabemos. Ese análisis hace búsquedas web en cada ejecución, así que los resultados recuperados también pueden haber cambiado entre una y otra. Sin registrar las dos fases por separado no podemos decir qué parte de esos ocho puntos viene de las búsquedas y qué parte del modelo que las evalúa. Es una pregunta abierta y la tenemos pendiente de instrumentar.
Son además dos ejecuciones, no un estudio. No tiene valor estadístico y no lo presentamos como tal.
Lo publicamos porque apunta a la raíz del asunto. La variabilidad no está solo en qué fuentes recupera un motor en cada momento. Está también en el modelo que interpreta esas fuentes. Cualquier herramienta que te dé un número de visibilidad en IA y dependa de un modelo generativo tiene esto debajo, lo haya mirado o no. La diferencia entre proveedores no es si su herramienta es determinista. Es si te lo cuentan.
Qué métricas sobreviven a esto, y cómo
La respuesta práctica no es dejar de medir. Es cambiar qué se mide y cómo se reporta.
Share of Voice. El porcentaje de respuestas donde aparece tu marca sobre el total de consultas analizadas. Es la métrica que mejor resiste, porque mide presencia agregada y no una respuesta concreta. Es justo lo que el estudio de SparkToro observó como estable.
Consistencia. El porcentaje de repeticiones de una misma consulta en las que apareces. Deja de ser un detalle técnico y pasa a ser información de negocio: aparecer en 9 de cada 10 ejecuciones y aparecer en 2 de cada 10 son dos situaciones comerciales distintas, aunque las dos cuenten como "aparece".
Posición media de mención. Aquí hay un matiz que casi siempre se cuenta mal, en las dos direcciones.
El orden de una lista concreta es muy inestable. La misma lista en el mismo orden aparece menos de una vez de cada mil. Quien te venda "tu posición en ChatGPT" como si fuera una posición de Google está vendiendo ruido.
Pero la posición media agregada de una marca sobre muchas consultas se comporta de otra forma. OtterlyAI la siguió a diario durante un mes y se movió entre 0,09 y 0,15 puestos por día, sin tendencia clara, con medias por motor entre 2,35 en Google AI Overviews y 3,31 en ChatGPT.
La conclusión práctica: no intentes leer en qué puesto saliste en una respuesta concreta. Sí tiene sentido seguir tu posición media agregada a lo largo del tiempo.
Y una regla que vale para las tres: un porcentaje de visibilidad sin su muestra, su fecha y el conjunto de consultas usado no se puede interpretar ni comparar. Cambiar las preguntas cambia el resultado. Si el conjunto no está fijo, la comparación entre meses no significa nada.
Dos fuentes de variabilidad que conviene no mezclar
Llegados aquí hay una distinción que casi nunca se hace y que ordena todo lo anterior. Tu número de visibilidad puede moverse por dos razones completamente distintas.
Variación entre ejecuciones. Repites exactamente la misma pregunta y la respuesta cambia. Es lo que midió SparkToro, repitiendo cada consulta entre 60 y 100 veces.
Variación entre consultas. Cambias qué preguntas usas y el resultado se mueve, aunque cada pregunta se ejecute una sola vez. Es lo que midió OtterlyAI.
Cuántas preguntas
Tomando subconjuntos aleatorios de preguntas de una base de 320, con la marca, los motores y el periodo fijos, OtterlyAI encontró que pasar de 10 a 100 consultas reducía la variación de la cobertura alrededor de un 73%.
Con 10 consultas, el 90% de los resultados caía entre el 39% y el 71%. Con 50, entre el 49% y el 62%. Con 100, entre el 51% y el 60%.
Fíjate bien en qué significa eso, porque es fácil leerlo mal. No dice que la misma medición repetida dé 39% o 71%. Dice que dos consultoras que midan la misma marca con diez preguntas distintas cada una pueden llegar a números muy diferentes, y las dos tener razón.
La mayor ganancia llega al principio y después se aplana. Y 100 no es un número universal, como advierte el propio estudio.
Cuántas repeticiones
Aquí también hay un número publicado, y viene de donde debe venir.
Tres investigadores de la Universidad de St. Gallen, Julius Schulte, Malte Bleeker y Philipp Kaufmann, publicaron en 2026 un trabajo cuyo título resume el asunto entero: Don't Measure Once. Analizaron 32 prompts en cuatro sectores sobre ChatGPT, Gemini, Google AI Mode y Perplexity, y repitieron cada prompt hasta diez veces el mismo día para medir cuánto convergía el resultado.
Su conclusión es concreta. Con siete ejecuciones por prompt, el error estándar de la tasa de detección de marca baja de 0,10. Con ocho, baja de 0,08. Para cobertura de fuentes hacen falta ocho, porque las fuentes varían más que las marcas, que es exactamente lo que encontró OtterlyAI por otro camino.
Su recomendación práctica: al menos siete ejecuciones por prompt y día para monitorizar marcas, y ocho si importan las fuentes citadas.
Pero hay que leer esas cifras con cuidado, porque invitan a un error de optimismo. Siete ejecuciones no te dan una medición precisa. Te dan, en esa muestra, un intervalo de confianza del 95% de alrededor de ±15,8 puntos porcentuales. Con ocho, de ±12,1.
Léelo otra vez. Siguiendo la recomendación de los autores al pie de la letra, una tasa de detección del 40% podría estar en realidad entre el 24% y el 56%.
Son además estimaciones obtenidas por remuestreo de diez ejecuciones observadas, no garantías aplicables a cualquier medición nueva. No es un estándar universal: depende de la muestra, de la métrica y de la precisión que busques.
Lo que sí da es una referencia empírica para dimensionar el problema. Con pocas repeticiones el margen de incertidumbre es considerable, y debería ir escrito al lado del resultado en vez de desaparecer detrás de un número redondo.
Juntando los dos ejes
Un conjunto de consultas corto te da un número frágil aunque lo repitas mucho. Muchas repeticiones de pocas preguntas no arreglan haber elegido las preguntas equivocadas.
Y eso lleva a una consecuencia que suele pasarse por alto: la medición empieza antes de ejecutar la primera pregunta. Empieza al decidir qué conversaciones representan de verdad el proceso de compra de tu cliente. Si eliges mal las preguntas, repetirlas cien veces solo consigue que midas con más precisión algo que no importa. Ese trabajo previo es lo que nosotros llamamos Prompt Research.
Por eso el conjunto de consultas usado importa tanto como el número de repeticiones, y por eso los dos deberían ir publicados junto al resultado.
Nuestra forma de decirlo es esta: no buscamos que la IA responda siempre igual. Medimos siempre de la misma forma.
Lo que esto cambia para una empresa B2B
Tres consecuencias prácticas, en orden de importancia.
Un diagnóstico puntual sirve para marcar el punto de partida, no para evaluar una tendencia. Te dice dónde estás hoy, con el margen que te permita su muestra. Lo que informa una decisión es esa misma medición repetida en el tiempo, que es para lo que existe un monitor de visibilidad.
Desconfía de las garantías. Si alguien te promete un número de citaciones para una fecha, está prometiendo sobre un sistema cuya salida cambia en cada ejecución. Con estos datos encima de la mesa, esa promesa no se puede sostener.
Hay espacio competitivo, aunque menos despejado de lo que suena. Un estudio de Semrush sobre 50.000 marcas, 1.094 categorías y más de 600.000 citaciones encontró que solo el 15,2% de las categorías analizadas tenía un líder claro en ChatGPT. Conviene leerlo con precisión: que no exista un líder claro según los criterios del estudio no significa que esas categorías no tengan competidores fuertes. Significa que ninguna marca aparecía con suficiente consistencia entre las distintas preguntas de un mismo tema. Es una oportunidad, no un terreno vacío.
Un ejemplo de por qué el número agregado no basta
Supongamos una consultora B2B que quiere saber si la recomiendan cuando alguien pregunta por transformación digital. Repite tres consultas diez veces cada una y obtiene esto.
| Consulta | Apariciones |
|---|---|
| Mejores consultoras de transformación digital | 8 de 10 |
| Consultoras para automatizar procesos empresariales | 2 de 10 |
| Alternativas a las grandes consultoras tecnológicas | 0 de 10 |
En 30 ejecuciones aparece 10 veces. Su cobertura agregada es del 33%.
Ese 33% es verdadero y es casi inútil por sí solo. Lo que informa una decisión está en el desglose: la marca existe en la consulta genérica y desaparece en cuanto el comprador concreta un problema o compara alternativas. Son dos huecos distintos, con dos trabajos distintos detrás.
Las cifras son ilustrativas y una muestra así no permitiría conclusiones firmes. Sirve para lo que sirve: el agregado te dice si tienes un problema, el desglose te dice cuál.
Los estudios no coinciden en todo
Y conviene decirlo, porque el sector suele presentar un solo estudio como si fuera consenso.
SparkToro encontró que Claude era ligeramente más consistente que los demás en devolver el mismo conjunto de marcas, pero el peor en repetir el orden. El trabajo de St. Gallen, midiendo similitud entre ejecuciones separadas menos de 24 horas, sitúa a Perplexity como el más estable en marcas y a Google AI Mode como el menos estable. Para fuentes citadas el orden cambia: Gemini es el más estable y ChatGPT el menos.
No se contradicen frontalmente, porque miden cosas distintas y con muestras distintas. Pero bastan para una conclusión prudente: no hay todavía un ranking fiable de qué motor es más estable, y cualquiera que te lo presente como un hecho cerrado está yendo por delante de los datos.
Hay un detalle del mismo trabajo que conviene tener presente. En su muestra, el 57,8% de las ejecuciones de ChatGPT no contenía ninguna cita, porque el modelo no activa búsqueda web en todas las consultas. Los investigadores excluyeron esas respuestas de su análisis de similitud entre fuentes. Es otra decisión metodológica que conviene conocer antes de comparar resultados entre motores.
Preguntas frecuentes
¿Por qué la IA no da la misma respuesta dos veces?
Porque no funciona como un índice de búsqueda que devuelve un orden fijo. Genera una respuesta nueva en cada ejecución. Y cuando usa búsqueda web, que no es en todas las consultas, también pueden variar las fuentes que recupera. Cambios internos en sus mecanismos de recuperación alteran qué cita sin que la pregunta cambie.
Entonces, ¿tiene sentido medir la visibilidad en IA?
Sí, pero no con una ejecución. Con un conjunto fijo de consultas, un número determinado de repeticiones y una fecha. Lo que se mide no es qué contestó la IA una vez, sino con qué frecuencia aparece tu marca sobre el total.
¿Cuántas consultas y repeticiones hacen falta?
Son dos preguntas distintas y ninguna tiene un número universal, pero las dos tienen referencias publicadas. Sobre cuántas consultas: según OtterlyAI, pasar de 10 a 100 redujo la variación de la cobertura alrededor de un 73%, comparando subconjuntos distintos de preguntas. Sobre cuántas repeticiones: un trabajo de la Universidad de St. Gallen encontró que con siete ejecuciones por prompt el error estándar de la detección de marca baja de 0,10 en su muestra, y recomienda al menos siete para monitorizar marcas y ocho si importan las fuentes. Es una referencia útil, no una regla aplicable a cualquier sector o motor. Para un seguimiento comercial lo decisivo es además que el conjunto no cambie entre periodos, porque si cambia la comparación no significa nada.
¿Sirve de algo saber en qué posición aparece mi marca dentro de la respuesta?
Menos de lo que suele venderse. El orden es la dimensión más inestable de todas: la misma lista en el mismo orden aparece menos de una vez de cada mil. Sigue siendo medible con suficientes repeticiones, pero un número de posición sin su muestra al lado no es información fiable.
¿Cómo sé si un informe de visibilidad en IA está bien hecho?
Pídele tres cosas: el conjunto de consultas usado, el número de repeticiones por consulta y la fecha. Si falta alguna, el informe no es reproducible. Y si no se puede reproducir, no se puede comparar con el del mes que viene.